ローカルLLMの構成を10層で整理|GPU・VRAMの目安とクラウドとの違い
 fcwpadmin
ローカルLLMとは、公開されている学習済みモデル(オープンウェイトモデル)を、自社のPCやサーバーで動かす大規模言語モデルです。入力した内容が社外のAIサービスに送られないため、機密を扱う業務でも使い道を検討できます。その代わり、クラウドのAIなら提供元が用意している部分を、自分たちで組み立てる必要があります。
ローカルLLMを検討し始めると、何をどこまでそろえればよいかで迷いませんか。わたしたちは、Claude Codeのような開発用のAIエージェントを、ローカルLLMで再現する検証を進めています。社内の技術すり合わせで、ローカルLLMの構成を10層に分けて整理しました。各層で何を選ぶか、どこで制約が決まるかを、すり合わせで出た質問とあわせてご紹介します。
この記事でわかること
- ローカルLLMを構成する10層と、層ごとの選択肢
- クラウドのAI(Claude など)と、どこが違うのか
- モデルの大きさとGPUのメモリ(VRAM)の関係
- 人数・用途別のGPUの目安と、よく出る質問への答え
目次
- 1. 先に押さえる用語
- 2. ローカルLLMの構成図:10層の全体像
- 3. クラウドのAIとの違いは「誰が持つか」と規模
- 4. 層ごとの選択肢
- 5. 制約はGPUのメモリ(VRAM)で決まる
- 6. チャットとコーディングエージェントの違い
- 7. 規模別のGPUスペックの目安
- 8. よくある質問(FAQ)
- 9. 次に確かめること
- 10. まとめ
1. 先に押さえる用語
本文では正式な用語を使います。初めての方は、次の表を先にご覧ください。
| 用語 | 意味 |
|---|---|
| トークン | モデルが文章を扱う単位。日本語では1トークンがおよそ1〜2文字(モデルによって変わる) |
| パラメーター(重み) | モデルが学習で得た数値の集まり。「8B」は80億個、「70B」は700億個を表す |
| VRAM | GPUに載っているメモリ。モデルの重みと、やり取り中の文脈をここに置く |
| オープンウェイトモデル | 重みが公開されていて、手元で動かせるモデル |
| 推論 | 学習済みのモデルに入力を与え、答えを生成させること |
| RAG | 回答のたびに社内資料などを検索し、モデルに読ませて答えさせる仕組み |
| ファインチューニング | 学習済みのモデルを、追加のデータで学習させて調整すること。重み全体を学習し直す「フルファインチューニング」と、一部だけを学習する方法がある |
| LoRA・QLoRA | ファインチューニングの一種。元のモデルの重みは固定し、小さな追加部分だけを学習する。QLoRAは、元のモデルを4bitに圧縮して扱い、さらにメモリを節約する |
2. ローカルLLMの構成図:10層の全体像
ローカルLLMは、大きく見ると4つのまとまりでできています。利用者が触る「クライアント」、文章を生成する「推論エンジン」、「モデル」、それを動かす「実行基盤」です。これを役割ごとに分けると、次の10層になります。
次の図は、利用者のプロンプトが上から下へ降り、ハードウェアで計算された結果がトークンとして上へ戻る流れを示しています。
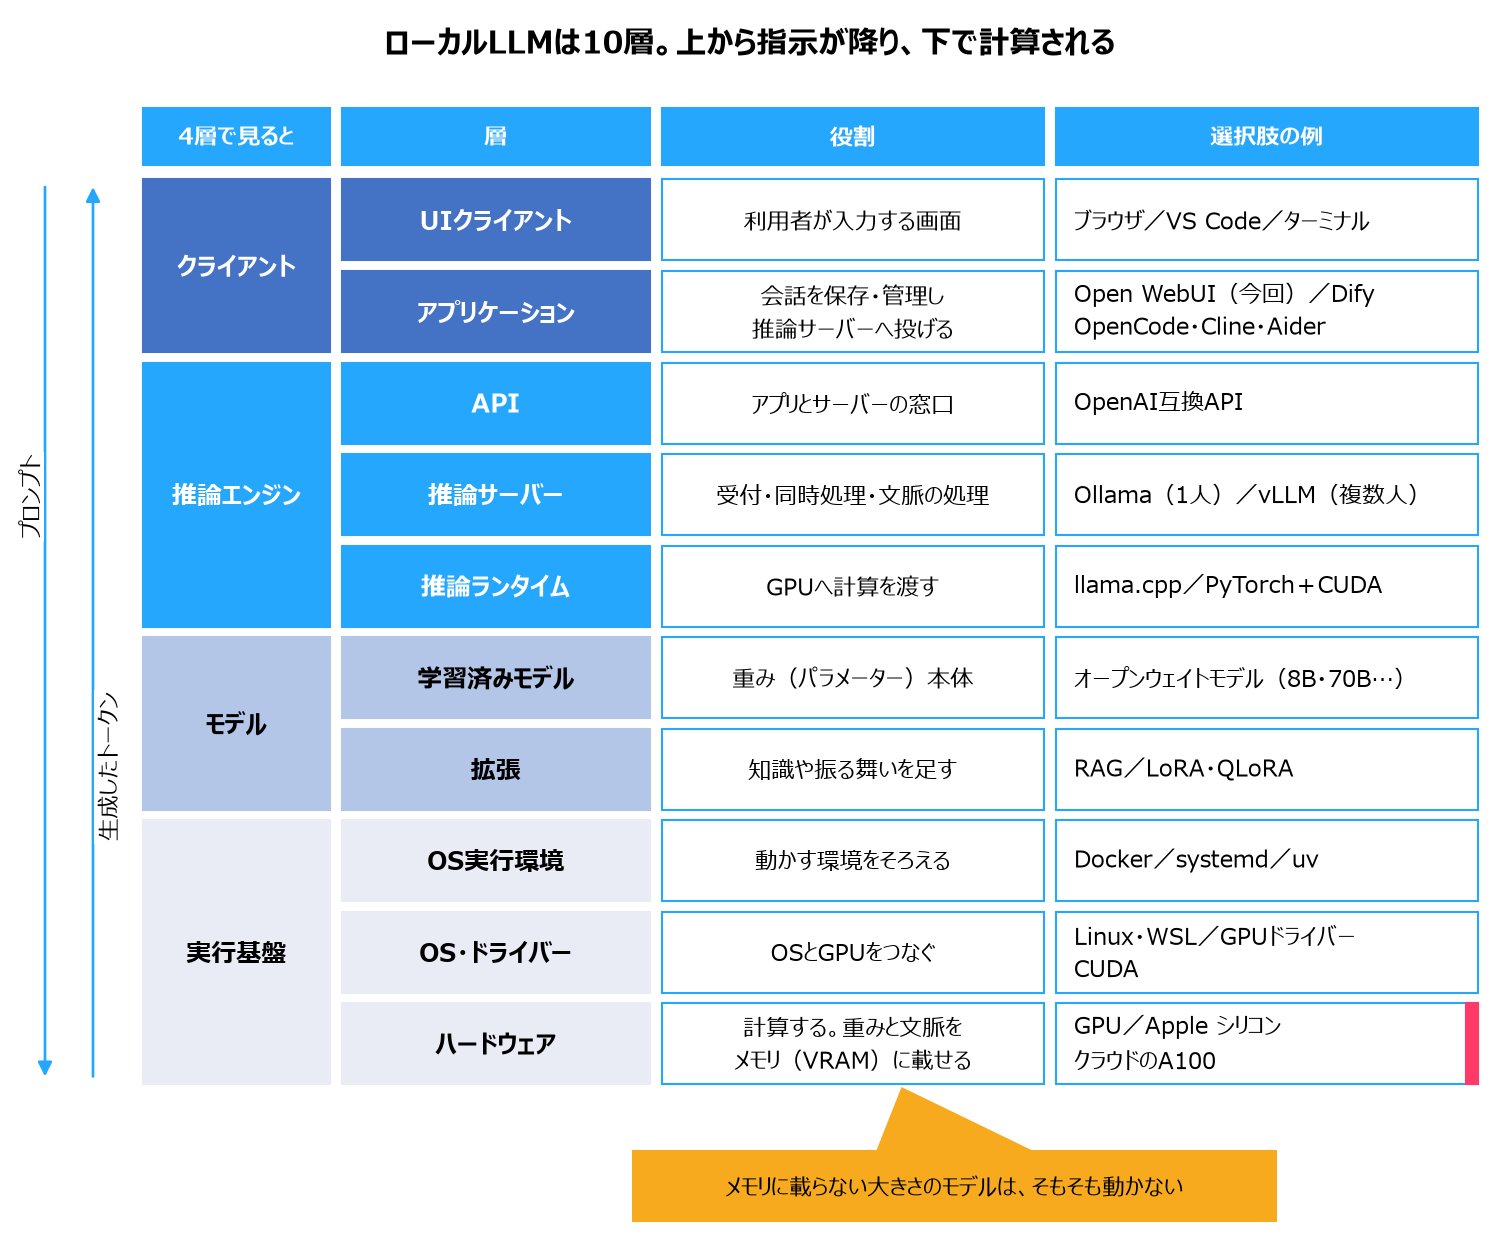
層の数は多く見えますが、OS実行環境とドライバーの層は、普段のLinuxでの開発とほとんど変わりません。検討に時間がかかるのは、アプリケーション、推論サーバー、モデル、ハードウェアの4層です。
3. クラウドのAIとの違いは「誰が持つか」と規模
クラウドのAIも、ローカルLLMと同じ4つのまとまりでできています。違うのは、各層を誰が持っているかと、規模の大きさです。次の図で、同じ観点を並べて比べます。
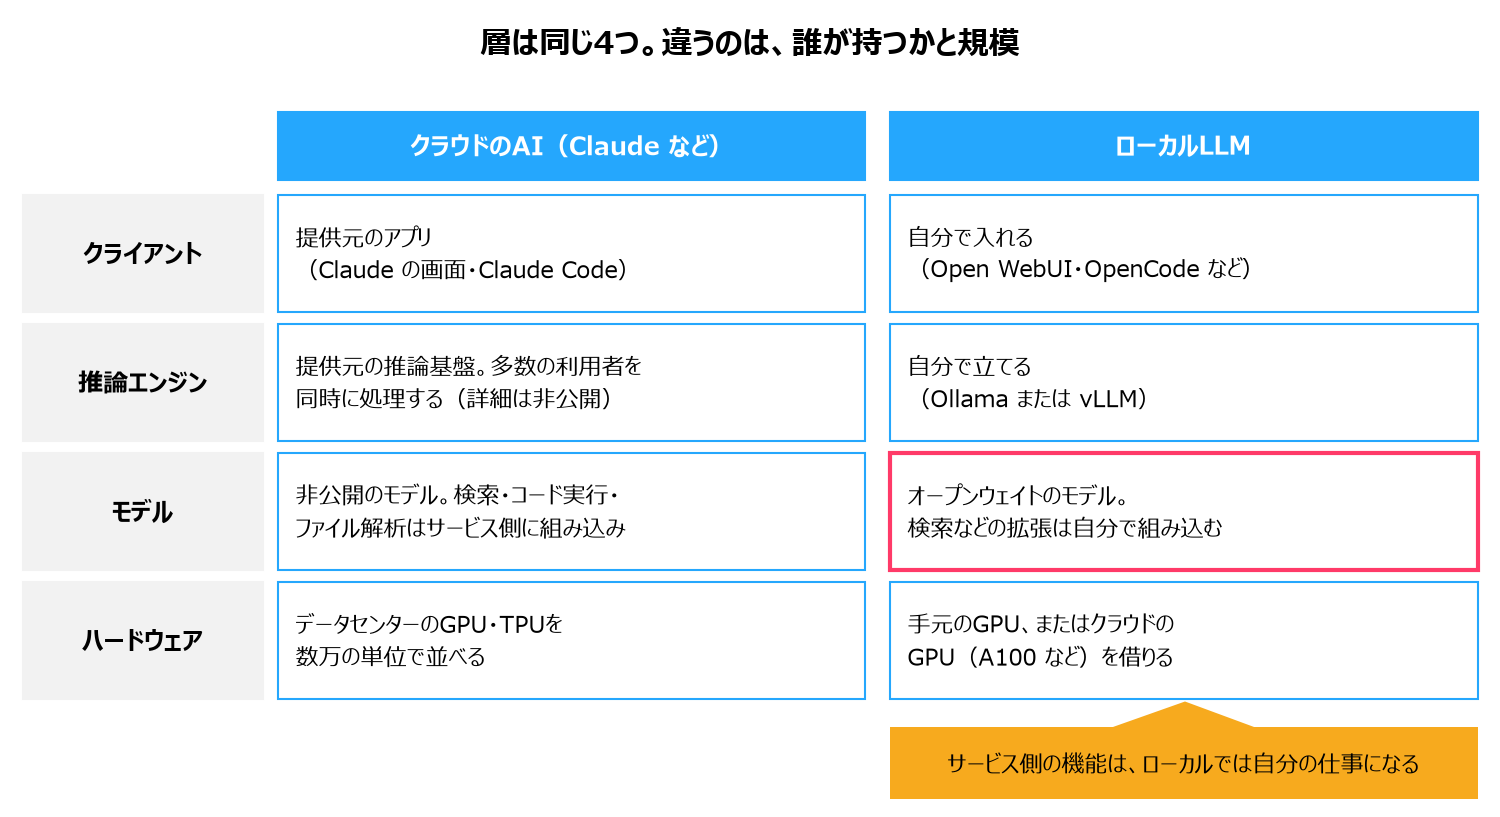
- クライアント:クラウドでは、Claudeの入力画面やClaude Codeを提供元が用意します。ローカルでは、Open WebUIなどのアプリを自分で入れます
- 推論エンジン:クラウドの推論基盤は、多数の利用者を同時に処理する仕組みを持っているはずです。ただし詳細は公開されていません
- モデル:クラウドのサービスには、検索、コード実行、ファイル解析といった機能が組み込まれています。モデルは「どの機能を使うか」を指示し、実際の処理はサービス側が行います。ローカルでは、これらを自分で組み込みます
- ハードウェア:クラウドはデータセンターで、GPUやTPUを数万の単位で動かしています。ローカルでは、手元のGPUか、借りたクラウドのGPUを使います
クラウドのAIで「最初からできていたこと」が、ローカルでは一つずつ作業になります。見積もりのときに、ここが漏れやすいと考えています。
4. 層ごとの選択肢
10層のうち、選び方で迷いやすい層を上から順に書きます。製品名は、すり合わせで候補に挙がったものです。
4-1. UIクライアント層とアプリケーション層
- UIクライアント層は、利用者が入力する画面です。ブラウザ、VS CodeやJetBrainsなどのエディタ、ターミナルがここに入ります。社内のチャット用途なら、基本はブラウザになります
- アプリケーション層は、会話を保存・管理し、推論サーバーへ投げる部分です。選び方は大きく2つあります
- パッケージ型:Open WebUI、LibreChat、AnythingLLMなど。入れればすぐにチャットとして使えます。今回の検証はOpen WebUIで始めました
- フレームワーク型:Streamlit、Difyなど。Pythonなどで画面と処理を組み立て、APIを呼ぶコードを足して作ります
- エージェント型:OpenCode、Cline、Aiderなど。Claude Codeのように、ファイルを読み書きしながら作業させるときに使います
4-2. API層・推論サーバー層・推論ランタイム層
- API層は、アプリケーションと推論サーバーをつなぐ窓口です。クラウドのAIと同じ形式のAPIを用意すると、アプリ側の作りを変えずに済みます
- 推論サーバー層は、プロンプトの受付、同時処理、文脈の処理を受け持ちます。1人で使うならOllama、複数人で同時に使うならvLLMが向いています
- 推論ランタイム層は、GPUに計算を渡す部分です。llama.cppや、PyTorchとCUDAの組み合わせがここに入ります。NVIDIAのGPUでは、PyTorchとCUDAを組み合わせることが多くなります
4-3. 学習済みモデル層と拡張層
- 学習済みモデル層は、オープンウェイトモデルの本体です。チャットに使うのは、会話に従うよう追加で学習された「指示調整済み」のモデルです
- 拡張層は、モデルに知識や振る舞いを足す部分です。RAG、LoRA・QLoRAがここに入ります
- 会社ごとの言い回しや出力の形をそろえたいときは、まず指示文(システムプロンプト)で指定し、足りなければLoRAで追加学習します。社内の知識を答えさせたいときは、RAGが向いています。モデルの重み全体を学習し直すフルファインチューニングは、学習済みモデル層そのものに手を入れる方法です
4-4. OS実行環境層・OS・ドライバー層・ハードウェア層
- OS実行環境層は、Docker、systemd、Pythonの仮想環境(uv)などで動かす環境をそろえる部分です。通常のLinuxでの開発と大きくは変わりません
- OS・ドライバー層は、LinuxかWindows上のLinux環境(WSL)を選び、GPUのドライバーとCUDAを入れる部分です
- ハードウェア層は、計算する機械そのものです。GPU、CPUとGPUを1つにまとめたApple シリコン(M3・M4など)、借りて使うクラウドのGPU(A100など)が候補になります
5. 制約はGPUのメモリ(VRAM)で決まる
すり合わせで何度も出たのは、「机の大きさ」というたとえでした。机はGPUのメモリ(VRAM)のことです。モデルが答えを作るときは、この机の上に資料を広げて作業しているイメージです。
- プロンプトを投げると、モデルは学習した重みをすべて使って計算します。そのため、重みの全量を机に載せておく必要があります。8Bより70Bのほうが、広い机が要ります
- 重みは、量子化という方法で圧縮できます。16bitから4bitにすると、必要なメモリは約4分の1になります。8Bのモデルが手元のGPUで動くのは、このためです
- 机には、やり取り中の文脈も載ります。指示文や会話の履歴が長いほど、机の空きは減ります
- モデルは、次に来るトークンを1つずつ予測しながら出力します。クラウドのAIでも文章が少しずつ表示されるのは、このためです
- 速さは、1秒あたりに出せるトークンの数で測ります。たとえば「1秒あたり10トークン」「1秒あたり100トークン」という比べ方をします
- 予測した候補からどれを選ぶか(サンプリング)は、温度という設定で変わります。設定や学習のしかたによっては、同じ表現を繰り返したり、文が崩れたりします
机が足りない問題に対して、CPUとGPUでメモリを共有する小型機も出てきました(NVIDIA DGX Spark など)。メモリを128GB積めるため、2,000億(200B)パラメーター程度のモデルまで動かせるとされています。
⚠️ 動くことと、実用になることは別です。大きなモデルがメモリに載っても、業務で待てる速さで答えが返るとは限りません。どの程度のGPUで、どの大きさのモデルが実用になるかは、わたしたちもこれから測るところです。
6. チャットとコーディングエージェントの違い
チャットとコーディングエージェントは、仕組みとしてはほとんど同じです。推論サーバーは同じvLLMのままで、アプリケーションが投げる中身だけが変わります。違いが出るのは、机に載せる文脈の大きさです。ただし、エージェントとして使うには、ツール呼び出しに対応したモデルを選び、推論サーバー側でもツール呼び出しを受ける設定をする必要があります。
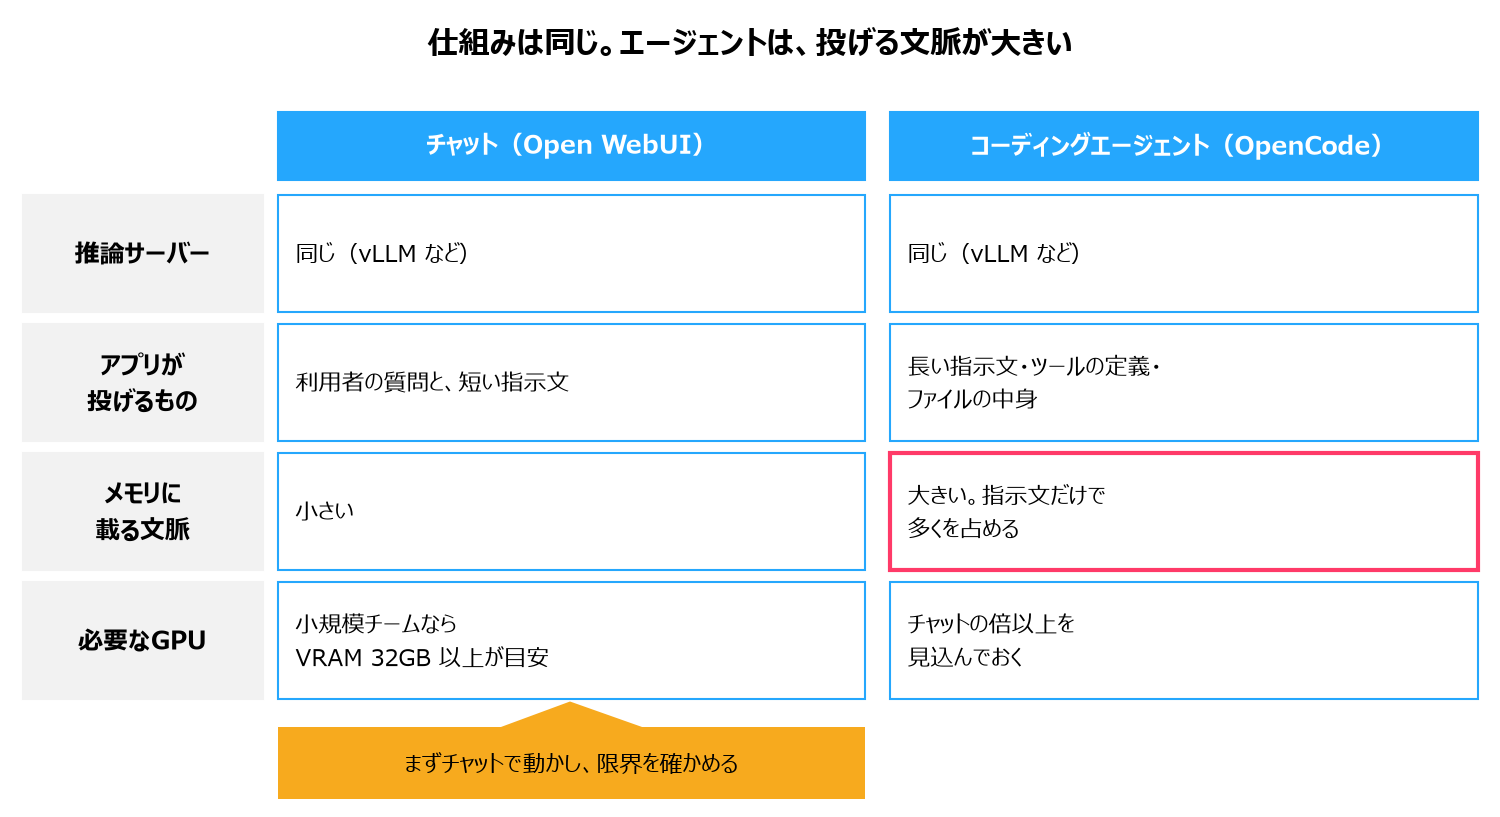
エージェント型のアプリは、ツールの使い方などを書いた長い指示文を毎回投げます。この指示文だけで、机の多くを占めてしまいます。
エージェントでは、指示文やツールの定義、ファイルの中身が毎回送られるため、文脈がチャットの数倍になります。道具を正確に使える、大きめのモデルも必要です。そのため、必要なGPUはチャットの倍以上を見込みます。
そこで今回は、いきなりOpenCodeを入れず、指示文の軽いOpen WebUIから始めました。まず机の大きさを把握し、どの程度の出力が出せるか、どこが限界かを確かめるためです。
7. 規模別のGPUスペックの目安
すり合わせで出した見立てを表にしました。実測した値ではなく、検証を始める前の目安です。
| 規模・用途 | 推論サーバー | ハードウェアの目安 |
|---|---|---|
| 個人で使う | Ollama | 検証で使っているPCのGPUで足りる |
| 小規模チーム(20人程度まで)でチャットに使う | vLLM | VRAM 32GB以上のGPU。民生向けで1枚120万円前後、業務用の大容量GPUでは数百万円規模(2026年時点、価格の変動が大きい) |
| 小規模チームで開発エージェントとして使う | vLLM | チャットの倍以上を見込む。大きなGPUを複数枚使う |
利用者のPCには、GPUはほとんど要りません。推論サーバーを別の機械に置けば、利用者はブラウザから使うだけだからです。GPUが要るのは、推論サーバーを動かす機械だけです。
8. よくある質問(FAQ)
Q1. RAGやMCPを入れると、GPUをたくさん使いますか?
A. 学習のような大きなGPUの負荷はかかりません。RAGやMCPは、モデルを学習させる仕組みではないからです。ただし、RAGで読ませる資料やMCPのツールの説明は、文脈として机(VRAM)に載ります。その分のメモリと処理時間は増えます。GPUを最も使うのは、モデル全体を学習し直すフルファインチューニングです。
Q2. フルファインチューニングとLoRA・QLoRAは、何が違いますか?
A. 学習し直す範囲が違います。どちらもファインチューニングの一種で、フルファインチューニングは8Bなどのモデル全体の重みを学習し直します。LoRA・QLoRAは、元のモデルの重みを固定したまま、小さな追加部分だけを学習します。
LoRA・QLoRAはGPUの使用量を抑えられます。その代わり、学習用のデータの準備と、やり直すときの再学習に手間がかかります。
Q3. 利用者のPCにもGPUは必要ですか?
A. 推論サーバーを別の機械に置くなら、ほとんど必要ありません。1台のPCで画面と推論サーバーの両方を動かす場合だけ、そのPCにGPUが要ります。1〜3B程度の小さなモデルならCPUだけでも動きますが、実用的な大きさのモデルでは、GPUがないとまともな速さになりません。
Q4. OllamaとvLLMは、どちらを選べばよいですか?
A. 使う人数で選びます。1人で使うならOllamaで足ります。複数人から同時に使うなら、同時処理に強いvLLMが向いています。
Q5. メモリ128GBの小型機なら、200Bのモデルが実用になりますか?
A. 動かせるとされていますが、実用の速さで答えが返るかは別です。わたしたちもまだ測っていません。業務で使えるかは、実際の質問を投げて、返ってくるまでの時間を測ってから判断します。
Q6. Claude Codeのような使い方をしたいのに、なぜ最初からOpenCodeを使わなかったのですか?
A. エージェント型のアプリは、指示文だけでGPUのメモリを大きく使うためです。先に指示文の軽いチャットで、どの大きさのモデルがどこまで動くかを把握したほうが、つまずいた原因を切り分けやすくなります。詳しくは6章に書きました。
Q7. 自社の言い回しや出力の形を覚えさせたいときは、どうしますか?
A. まず指示文で指定し、足りなければLoRAを検討します。社内の知識を答えさせたい場合はRAGが向いています。モデル全体を学習し直すフルファインチューニングは、GPUと時間を大きく使うため、最後の選択肢と考えています。
9. 次に確かめること
今回のすり合わせで、次の検証では開発用のエージェントに重きを置くことにしました。確かめることは3つです。
- OpenCodeを推論サーバーにつなぎ、エージェントとしてどう動くかを見る
- どの程度のGPUで、どの大きさのモデルが実用の速さで動くかを測る
- 対象のプログラミング言語を絞ったほうが、モデルを小さくできるかを確かめる
結果は、このナレッジレポートで改めてご紹介します。
10. まとめ
- ローカルLLMは、クライアント・推論エンジン・モデル・実行基盤の4つ、役割で分けると10層でできている
- クラウドのAIとの違いは、各層を誰が持つかと規模。サービス側に組み込まれた機能は、ローカルでは自分で組み込む
- 使えるモデルの大きさは、GPUのメモリ(VRAM)で決まる。重みの全量と文脈が載る必要がある
- チャットとエージェントは仕組みが同じ。エージェントは文脈もモデルも大きくなるぶん、GPUを倍以上見込む
- 大きなモデルが「動く」ことと「実用になる」ことは別。速さを測ってから判断する
関連記事と参考資料
- Agentforce Vibesを使ってみた|Salesforce実装の強みとClaude Codeとの使い分け【2026年版】
- Claude Codeプラグインをインストールしてチームで使う
- Open WebUI(公式ドキュメント)
- Ollama(公式サイト)
- vLLM(公式ドキュメント)
- llama.cpp(GitHub)
- OpenCode(公式サイト)
- NVIDIA DGX Spark(NVIDIA)
ご相談ください
次のような課題をお持ちでしたら、お問い合わせください。現状のヒアリングから、実現できるかの検討までご相談を承ります。
- 機密を扱う業務で、社外に出さずに生成AIを使いたい
- ローカルLLMを入れたいが、必要なGPUや構成の見当がつかない
- クラウドのAIとローカルLLMを、業務ごとに使い分けたい